Die NVIDIA RTX Spark Laptops gibt es in verschiedenen Konfigurationen. Neben zwei Varianten des N1X-Chips, die sich bei den CPU- und GPU-Kernen unterscheiden, hast du auch beim Unified Memory die Wahl. Doch wie viel Speicher brauchst du, wenn du lokale KI-Modelle wie Devstral Small 24B, Muse Glimmer 30B oder GLM-4.5-Air auf deinem Laptop ausführen möchtest? Reichen 32 GB oder lohnt sich der Aufpreis für 64 beziehungsweise 128 GB Unified Memory?
In diesem Blog erfährst du, für welche lokalen KI-Modelle du wie viel Unified Memory benötigst.
Inhaltsverzeichnis
Was ist Unified Memory bei NVIDIA RTX Spark Geräten?
Bei herkömmlichen Laptops sind Arbeitsspeicher (RAM) und Grafikspeicher (VRAM) voneinander getrennt. Während der Prozessor auf den RAM zugreift, nutzt die Grafikkarte ihren eigenen VRAM. NVIDIA RTX Spark setzt dagegen auf Unified Memory. Dabei teilen sich CPU und GPU einen gemeinsamen Speicherpool, auf den beide zugreifen können.
Das bringt vor allem bei speicherintensiven Anwendungen Vorteile. Besonders interessant ist Unified Memory für lokale KI-Modelle, die normalerweise viel Grafikspeicher benötigen. Statt auf den fest verbauten VRAM einer dedizierten Grafikkarte beschränkt zu sein, kann die GPU einen größeren Teil des gemeinsamen Speichers nutzen. Dadurch lassen sich auch KI-Modelle lokal ausführen, die den VRAM vieler herkömmlicher Gaming-Laptops übersteigen.
Ein Beispiel: Du möchtest ein lokales KI-Modell ausführen, das rund 22 GB Speicher benötigt. Auf einem RTX-Spark-Laptop mit 64 GB Unified Memory bleibt damit grundsätzlich noch genügend Speicher für das Betriebssystem, Google Chrome und andere Anwendungen übrig. Bei einem deutlich größeren KI-Modell, das beispielsweise 55 GB benötigt, wird es dagegen eng. Schließlich braucht nicht nur das KI-Modell Speicher, sondern auch der Rest deines Systems.
Allerdings sind 64 GB Unified Memory nicht mit 64 GB dediziertem VRAM gleichzusetzen. Da sich CPU und GPU den Speicher teilen, steht nicht die gesamte Kapazität ausschließlich der Grafikeinheit zur Verfügung. Auch das Betriebssystem und andere Anwendungen benötigen Speicher.
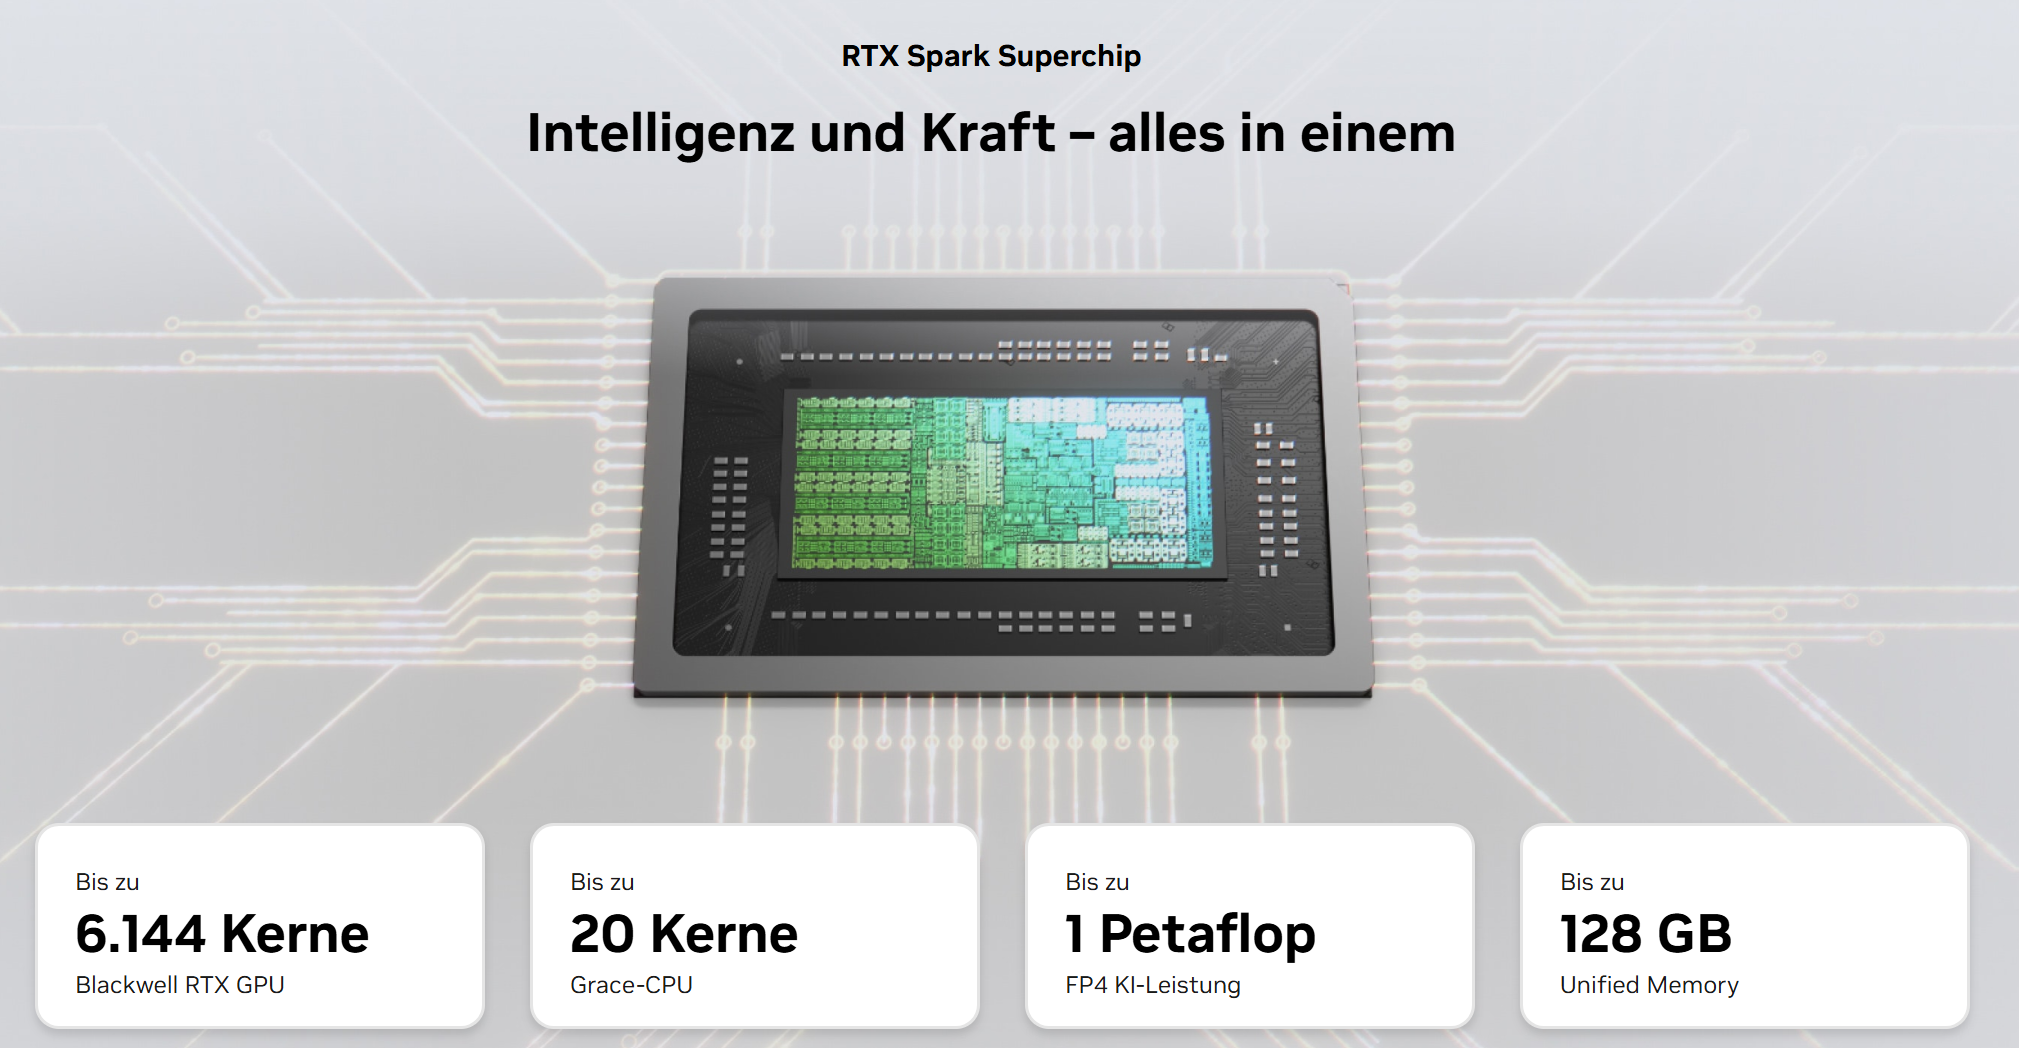
RTX Spark mit 32, 64 oder 128 GB Unified Memory im Vergleich
| 32 GB | 64 GB | 128 GB | |
|---|---|---|---|
| Gaming | Sehr gut geeignet | Sehr gut geeignet | Selten zusätzlicher Vorteil |
| Bildbearbeitung | Gut | Sehr gut | Für große Projekte |
| Videoschnitt | Kleinere bis mittlere Projekte | Anspruchsvolle Projekte | Große professionelle Projekte |
| 3D-Rendering | Kleinere Szenen | Komplexere Szenen | Besonders große Szenen |
| Lokale KI | Quantisierte 24B-/30B-Modelle | 30B in 8-Bit, 70B Q4 unter Vorbehalt | 100B+-Modelle, quantisiert |
Welche KI-Modelle laufen auf RTX Spark?
Die größten Vorteile bietet Unified Memory bei lokaler KI. Das bedeutet aber nicht, dass du jedes Modell mit jeder Speicherkonfiguration ausführen kannst. Da der Unified Memory fest verbaut ist und somit nicht im Nachhinein vergrößert werden kann, ist es wichtig, zu wissen, wie viel Speicher du für welche Modelle brauchst.
Warum benötigen eigentlich KI-Sprachmodelle unterschiedlich viel Speicher?
KI-Modelle haben unterschiedliche Größen, aber warum? Angaben wie 30B oder 70B geben die Anzahl der Parameter an – 30B-Modelle haben also 30 Milliarden Parameter (Billion ist das englische Wort für Milliarden), die im Speicher abgelegt werden müssen.
Mit einer sogenannten Quantisierung kann der Speicherbedarf reduziert werden. Das bedeutet, dass die Modelle mit weniger Bits gespeichert werden. Ein 30B-Modell braucht beispielsweise 60 GB in 16-Bit, in 8-Bit nur noch 30 GB und in 4-Bit nur 15 GB. Dadurch sind auch größere Modelle auf Geräten mit begrenztem Speicher möglich. Allerdings kann die Qualität der Ergebnisse dadurch beeinflusst werden.
Neben den Modellgewichten benötigen KI-Anwendungen zusätzlichen Speicher. Dazu gehört der KV-Cache, in dem Informationen aus bereits verarbeiteten Eingaben zwischengespeichert werden. Je länger eine Unterhaltung oder ein analysiertes Dokument, desto größer kann dieser Speicherbedarf ausfallen.
Entscheidend ist außerdem, ob ein KI-Modell lediglich in den verfügbaren Arbeitsspeicher passt oder vollständig von der GPU verarbeitet werden kann. Müssen Teile der Berechnung auf die CPU ausgelagert werden, kann die Ausführung langsamer werden.
Genau hier kommen die unterschiedlichen Speicherkonfigurationen von NVIDIA RTX Spark ins Spiel: Mit 64 oder 128 GB Unified Memory lassen sich größere Modelle oder weniger stark quantisierte Varianten nutzen, für die 32 GB nicht ausreichen.
Welche LLMs laufen mit 32, 64 oder 128 GB Unified Memory?
Je mehr Unified Memory das Gerät hat, umso größere lokale KI-Sprachmodelle können also ausgeführt werden. Wir haben dir einige KI-Sprachmodelle aufgelistet, die du lokal ausführen kannst, und wie viel Speicher du brauchst. Es sind aber nur Beispiele, da immer wieder neue Modelle hinzukommen.
Lokale KI-Modelle mit 32 GB Unified Memory
Besonders bei RTX Spark Modellen mit 32 GB Unified Memory bist du auf Quantisierung – einer Reduzierung des Speicherbedarfs – angewiesen.
Beispiele für passende KI-Modelle:
- Muse Glimmer 30B: Für KI-Agenten, die komplexere Aufgaben bearbeiten und verschiedene Werkzeuge nutzen können. Mit 4-Bit-Quantisierung benötigt das Modell ungefähr 17 bis 20 GB Speicher für seine Gewichte.
- Devstral Small 24B: Ein auf Softwareentwicklung spezialisiertes Modell, das beim Schreiben, Analysieren und Überarbeiten von Code hilft. In einer 4-Bit-Version benötigt es ungefähr 13 bis 15 GB.
Diese Modelle eignen sich für Entwickler und Nutzer, die lokale KI ausprobieren möchten. Bei umfangreichen Codeprojekten oder langen Kontextfenstern kann der Speicher allerdings knapp werden.
64 GB Unified Memory – Größere Modelle und höhere Präzision
Mit 64 GB Unified Memory stehen dir schon wesentlich größere KI-Sprachmodelle zur Verfügung. Hier ist auch eine weniger starke Quantisierung möglich.
Beispiele:
- 30B-Modelle mit 8-Bit-Quantisierung: Benötigen etwa 30 bis 35 GB für ihre Modellgewichte. Durch die höhere Präzision bleiben mehr Informationen der ursprünglichen Modellgewichte erhalten.
- 70B-Modelle mit 4-Bit-Quantisierung: Benötigen je nach Modell und Quantisierungsformat etwa 40 bis 45 GB. Sie können auf einem 64-GB-Gerät infrage kommen, sofern ausreichend Speicher verfügbar ist und die Inferenzsoftware die Speicherverwaltung unterstützt.
Vor allem für Nutzer, die regelmäßig mit lokalen KI-Modellen arbeiten, bieten 64 GB mehr Flexibilität. Auch längere Kontextfenster und parallele Anwendungen profitieren von der zusätzlichen Kapazität.
Besonders große lokale KI-Sprachmodelle mit 128 GB Unified Memory
Wer KI-Modelle mit über 100 Milliarden Parametern lokal ausführen möchte, benötigt deutlich mehr Speicher. Hier kommt die 128-GB-Konfiguration ins Spiel.
Beispiele:
- Devstral 2 123B: Ein großes KI-Modell für Softwareentwicklung, Codeanalyse und komplexe Programmieraufgaben. In einer 4-Bit-Version benötigen die Modellgewichte ungefähr 70 bis 80 GB.
- GLM-4.5-Air: Ein KI-Modell mit rund 106 Milliarden Gesamtparametern, das für Reasoning, Coding und KI-Agenten entwickelt wurde. In 4-Bit-Quantisierung benötigt es ungefähr 60 bis 70 GB für seine Gewichte.
Mit 128 GB Unified Memory lassen sich solche Modelle grundsätzlich lokal betreiben, sofern die Software und GPU-Speicherverwaltung dies unterstützen. Gleichzeitig bleibt mehr Platz für den KV-Cache, längere Kontextfenster und weitere Anwendungen.
KI-Modelle und Speicherbedarf im Direktvergleich
Hier findest du eine Zusammenfassung der KI-Modelle und ihren ungefähren Speicherbedarf in einer kompakten Tabelle.
| Unified Memory | KI-Modell | Quantisierung | Speicherbedarf (ca.) |
|---|---|---|---|
| 32 GB | Muse Glimmer 30B | 4-Bit | 17–20 GB |
| 32 GB | Devstral Small 24B | 4-Bit | 13–15 GB |
| 64 GB | 30B-Modelle | 8-Bit | 30–35 GB |
| 64 GB | 70B-Modelle | 4-Bit | 40–45 GB |
| 128 GB | Devstral 2 123B | 4-Bit | 70–80 GB |
| 128 GB | GLM-4.5-Air | 4-Bit | 60–70 GB |
Die Übersicht hilft dir dabei, die verschiedenen Speicherkonfigurationen besser einzuordnen
FAQ – Häufige Fragen zu NVIDIA RTX Spark und Unified Memory
- Lesedauer 8 min

Gina Wollschläger
Autor
Gina, aufgewachsen in einem kleinen Dorf mitten in Brandenburg, ist mit jungen 18 Jahren nach Berlin gezogen, wo sie zuerst eine schulische Ausbildung zur Assistentin für Medieninformatik absolviert und dann das Abitur nachgeholt hat. Während eines Studiums, in dem sie unzufrieden war, ist sie erst als Werkstudentin bei Caseking gelandet. Schon in jüngeren Jahren hat sie angefangen, Geschichten zu schreiben und mit 20 hat sie sich schließlich einen Gaming-PC gebaut. Passend zu diesen beiden Leidenschaften schreibt sie nun Vollzeit über Hardware und Gaming und taucht in ihrer Freizeit am liebsten in fremde Welten wie Cyberpunk oder Assassins Creed ein, wenn sie nicht mit Freunden die reale Welt entdeckt.
Mehr erfahren >>