Inhaltsverzeichnis
Was sind AI Tokens und warum taucht dieser Begriff überall auf, sobald es um Chatbots, LLMs oder lokale AI geht?
Vereinfacht gesagt sind Tokens die kleinen Bausteine, in die ein AI-Modell deine Eingaben zerlegt und aus denen es anschließend seine Antwort zusammensetzt.
Tokens entscheiden dabei nicht nur darüber, wie ein Sprachmodell Texte verarbeitet. Sie beeinflussen auch die maximale Länge eines Chats, die Geschwindigkeit der Ausgabe und bei vielen Cloud-Diensten sogar die Kosten.
Wer AI dagegen lokal auf dem eigenen PC betreibt, muss zwar weiterhin mit Tokens rechnen – bezahlt aber nicht jeden einzelnen davon an einen Anbieter.
Was sind AI Tokens?
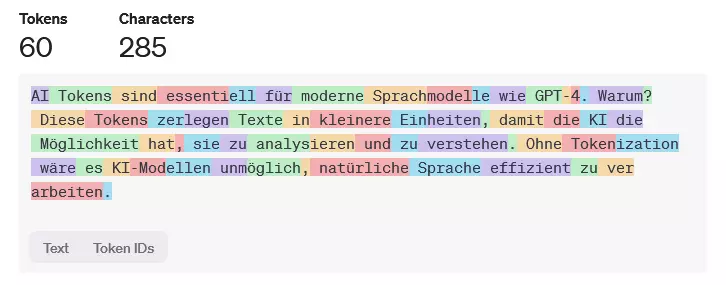
Ein Sprachmodell verarbeitet einen Satz nicht einfach Wort für Wort so, wie wir ihn lesen. Stattdessen zerlegt ein sogenannter Tokenizer den Text in kleinere Einheiten: die Tokens.
Ein Token kann ein vollständiges Wort sein, aber genauso nur ein Teil davon, ein einzelnes Zeichen oder ein Satzzeichen. Selbst Schreibweise, Leerzeichen und verwendete Sprache können beeinflussen, wie ein Text zerlegt wird. Deshalb gilt: Ein Token ist nicht automatisch ein Wort.
Nehmen wir beispielsweise das Wort:
Grafikkarte
Für dich ist das ein einziges Wort. Ein Tokenizer könnte daraus jedoch mehrere Bestandteile machen. Wie genau diese Aufteilung aussieht, hängt vom jeweiligen Modell und dessen Tokenizer ab.
Kurze und häufig vorkommende Wörter passen dagegen häufig in ein einzelnes Token.
Das ist einer der Gründe, warum zwei AI-Modelle für exakt denselben Text unterschiedlich viele Tokens benötigen können.
Welche Arten von AI Tokens gibt es?
Nicht alle Tokens erfüllen denselben Zweck. Gerade bei AI-APIs und Reasoning-Modellen begegnen dir unterschiedliche Bezeichnungen. Für den Einstieg reichen diese vier Kategorien:
| Token-Art | Was bedeutet das? |
| Input Tokens | Tokens, die du dem Modell als Eingabe übergibst. Dazu gehören dein Prompt, vorherige Nachrichten und zusätzlicher Kontext. Sie werden auch als Prompt Tokens bezeichnet. |
| Output Tokens | Tokens, die das AI-Modell für seine Antwort erzeugt. Bei manchen APIs werden sie auch Completion Tokens genannt. |
| Cached Input Tokens | Bereits verarbeitete Eingaben, die über Prompt Caching erneut genutzt werden können. Je nach Anbieter können dafür andere Preise gelten als für normale Input Tokens. |
| Reasoning Tokens | Tokens, die bestimmte Reasoning-Modelle intern für ihre Verarbeitung nutzen, bevor sie die sichtbare Antwort erzeugen. |
Für die meisten Nutzer sind vor allem Input und Output Tokens wichtig. Sie bestimmen, wie viel Text ein Modell verarbeitet und erzeugt – und bei vielen Cloud-Diensten letztlich auch, wie hoch die Kosten ausfallen.
Wie funktionieren Tokens bei einem AI-Modell?
Schreibst du einer AI beispielsweise:
„Welche Grafikkarte brauche ich für ein lokales LLM?“
Landet dieser Satz nicht direkt im Sprachmodell. Zuerst zerlegt der Tokenizer deine Eingabe in Tokens und ordnet diesen intern Zahlenwerte zu.
Das Modell verarbeitet anschließend diese numerische Darstellung und berechnet, welches Token mit hoher Wahrscheinlichkeit als Nächstes folgen sollte. Danach wiederholt sich der Vorgang.
Token für Token entsteht daraus schließlich die Antwort.
Genau deshalb erscheint die Antwort vieler Sprachmodelle nach und nach auf dem Bildschirm. Das Modell generiert sie während der Inferenz Stück für Stück.
Wie viele Wörter sind 1.000 Tokens?
Eine feste Umrechnung gibt es nicht. Wie viele Tokens ein Text benötigt, hängt unter anderem von Sprache, Modell, Tokenizer und Inhalt ab.
Für englischen Text gilt als grobe Faustregel:
1.000 Tokens entsprechen ungefähr 750 Wörtern.
Oder anders gerechnet: Ein Token entspricht im Englischen durchschnittlich etwa vier Zeichen beziehungsweise ungefähr drei Vierteln eines Wortes. Diese Werte sind allerdings lediglich Näherungen. Bei deutschen Texten können die Ergebnisse aufgrund längerer Wörter und anderer Wortstrukturen deutlich anders aussehen.
Was haben Tokens mit dem Kontextfenster zu tun?
Tokens bestimmen auch, wie viele Informationen ein Sprachmodell gleichzeitig berücksichtigen kann. Hier kommt das sogenannte Kontextfenster oder „Context Window“ ins Spiel.
Hat ein Modell beispielsweise ein Kontextfenster von 32.000 Tokens, können innerhalb dieses Limits unter anderem deine Eingabe, Teile des bisherigen Gesprächs, zusätzliche Dokumente und die generierte Antwort verarbeitet werden.
Wird das Limit erreicht, müssen ältere oder weniger relevante Informationen entfernt, zusammengefasst oder anderweitig gekürzt werden. Die genaue Vorgehensweise hängt von der jeweiligen Anwendung ab.
Ein größeres Kontextfenster ermöglicht entsprechend längere Gespräche oder umfangreichere Dokumente. Gleichzeitig steigt jedoch der Rechen- und Speicheraufwand.
Das wird auch beim Thema lokale KI wichtig: Sehr große Modelle und lange Kontexte stellen höhere Anforderungen an deine Hardware.
Was kosten KI‑Tokens?
Bei vielen kommerziellen KI-APIs sind Tokens gleichzeitig die Abrechnungseinheit. Dabei wird meist zwischen zwei wichtigen Arten unterschieden:
Input Tokens sind alles, was das Modell als Eingabe verarbeiten muss. Dazu gehören beispielsweise dein Prompt, vorherige Nachrichten oder zusätzliche Kontextinformationen.
Output Tokens sind die Tokens, die das Modell anschließend für seine Antwort erzeugt.
Je nach Dienst können dafür unterschiedliche Preise gelten. Häufig wird der Preis pro einer Million Tokens angegeben. Welche Kosten tatsächlich entstehen, hängt stark vom verwendeten Modell und Anbieter ab.
Bei den meisten KI-Abonnements bekommst du davon nicht unbedingt unmittelbar etwas mit. Wer Modelle über eine API in eigene Programme, KI-Agenten oder andere Anwendungen integriert, muss den Token-Verbrauch dagegen häufig direkt berücksichtigen.
Ein langer Prompt plus eine lange Antwort kann entsprechend mehr kosten als eine kurze Anfrage.
Und genau an dieser Stelle wird lokale AI interessant.
Lokale künstliche Intelligenz: Keine Rechnung für jede Anfrage
Läuft ein Sprachmodell direkt auf deinem eigenen Gaming-PC oder einer KI-Workstation, funktioniert das Modell grundsätzlich weiterhin mit Tokens.
Der entscheidende Unterschied: Du zahlst keinem externen Anbieter einen festen Betrag pro verarbeitetem oder generiertem Token.
Stattdessen verschieben sich die Kosten auf deine eigene Hardware. Dazu gehören insbesondere Grafikkarte, Arbeitsspeicher, Stromverbrauch und gegebenenfalls weitere Komponenten.
Tokens sind lokal also nicht kostenlos im Sinne von „sie benötigen keine Ressourcen“. Deine GPU muss jeden Token weiterhin berechnen. Es gibt lediglich keinen Anbieter, der dir anschließend beispielsweise eine Million generierte Tokens in Rechnung stellt.
Bei selbst betriebenen Sprachmodellen lässt sich deshalb theoretisch ebenfalls ein effektiver Preis pro Token berechnen. Dieser ergibt sich dann jedoch aus Hardwarekosten, Stromverbrauch und Auslastung statt aus einer festen API-Preisliste.
Gerade wenn du deine Hardware ohnehin besitzt, entsteht dadurch ein völlig anderes Nutzungsmodell: Du kannst dein lokales KI-Modell immer wieder verwenden, ohne bei jedem langen Chat auf einen wachsenden Token-Zähler beim AI-Anbieter schauen zu müssen.
Tokens pro Sekunde: Die FPS der lokalen AI?
Wenn du dich mit lokalen Sprachmodellen beschäftigst, wirst du noch eine weitere Angabe häufig sehen:
Tokens pro Sekunde – kurz tok/s.
Damit wird beschrieben, wie schnell ein Modell Tokens erzeugt. Je höher der Wert, desto schneller erscheint die generierte Antwort.
Für Gaming-Enthusiasten lässt sich das grob mit FPS beim Gaming vergleichen. Die Werte beschreiben zwar völlig unterschiedliche Dinge, erfüllen aber einen ähnlichen Zweck: Sie machen Performance vergleichbar.
Wie viele Tokens pro Sekunde dein System erreicht, hängt unter anderem vom AI-Modell, dessen Größe und Einstellungen sowie deiner CPU, GPU und Speicherbestückung ab.
Vor allem der verfügbare VRAM deiner Grafikkarte wird beim Betrieb lokaler KI-Modelle schnell zu einem wichtigen Faktor.
FAQ: Häufige Fragen zu AI Tokens
Tokens sind klein – für lokale AI aber entscheidend
Tokens wirken zunächst wie ein unscheinbares technisches Detail. Tatsächlich begegnen sie dir aber an fast jeder Stelle, wenn du tiefer in lokale KI einsteigst.
Das Gute daran: Du musst sie weder zählen noch jedes Detail der Tokenisierung kennen, um AI auf deinem eigenen Rechner zu nutzen.
Nutzt du bereits lokale AI auf deinem PC oder bist du gerade erst dabei, dich mit dem Thema zu beschäftigen? Schreib es uns gerne in die Kommentare!
- Lesedauer 8 min

Marcel Bruns
Autor
Marcel stammt aus Bonn und ist im Berliner Umland aufgewachsen. Schon in der Schulzeit entwickelte er eine Leidenschaft für Technik und Gaming – seinen ersten PC zerlegte er direkt nach dem Auspacken, einfach um zu verstehen, wie er funktioniert. Bis heute baut er regelmäßig Gaming-PCs für sich und Freunde zusammen. Wenn er gerade nicht an seinem PC herumschraubt, taucht er gerne in die Welt der Anime ein und träumt davon, einmal Japan zu bereisen. In seiner Freizeit trifft man ihn entweder beim Zocken des neuesten AAA-Titels oder dabei, seine Teammates in League of Legends (mehr oder weniger absichtlich) zu inten.
Mehr erfahren >>