Inhaltsverzeichnis
Der GPU Unlock kann die Tensor-Core-Leistung ausgewählter Nvidia-Grafikkarten der RTX-20-, RTX-30- und RTX-40-Serie bei bestimmten KI-Berechnungen nahezu verdoppeln.
Aktuelle Mods umgehen eine Leistungsbegrenzung, die bisher vor allem professionelle RTX-Grafikkarten von ihren GeForce-Pendants unterschied.
Modder entsperren die KI-Leistung älterer RTX-Grafikkarten
Ende Oktober 2026 zeigen mehrere Modding-Projekte, dass Nvidia bei verschiedenen GeForce-Generationen einen Teil der verfügbaren Tensor-Rechenleistung begrenzt. Die Einschränkung lässt sich offenbar per Software umgehen, ohne das VBIOS der Grafikkarte zu verändern.
Den Ausgangspunkt bildet das Open-Source-Projekt GPU Unlock, das ursprünglich für die Ampere-Architektur der RTX-30-Serie entwickelt wurde. Inzwischen gibt es Erweiterungen für Ada Lovelace (RTX 40) und Turing (RTX 20).
Ein Test vom 22. Oktober 2026 bestätigt beispielsweise eine erfolgreiche Freischaltung auf einer GeForce RTX 2080 Ti. Auch für die RTX 4090 und weitere Modelle liegen entsprechende Messergebnisse vor.
Die drei wichtigsten Projekte sind:
- Turing Unlock: Forschungsprojekt für RTX-20-Grafikkarten, bisher insbesondere auf der RTX 2080 Ti getestet.
- GPU Unlock: Ursprüngliches Projekt für die RTX-30-Serie, inzwischen mit weiteren unterstützten Architekturen.
- GPU Unlock Ada: Erweiterung für RTX-40-Grafikkarten wie die RTX 4090 und experimentell weitere Ada-Modelle.
Die Unterstützung unterscheidet sich allerdings je nach Modell. Während für viele RTX-30-Grafikkarten bereits mehrere erfolgreiche Tests vorliegen, befinden sich die Freischaltungen der RTX-20- und RTX-40-Serie teilweise noch im experimentellen Stadium.
Wie funktioniert GPU Unlock?
Nvidia verwendet auf GeForce-Grafikkarten teilweise dieselben GPU-Chips wie auf professionellen Workstation-Modellen. Trotzdem unterscheiden sich die verfügbaren Rechenleistungen bei bestimmten KI-Operationen.
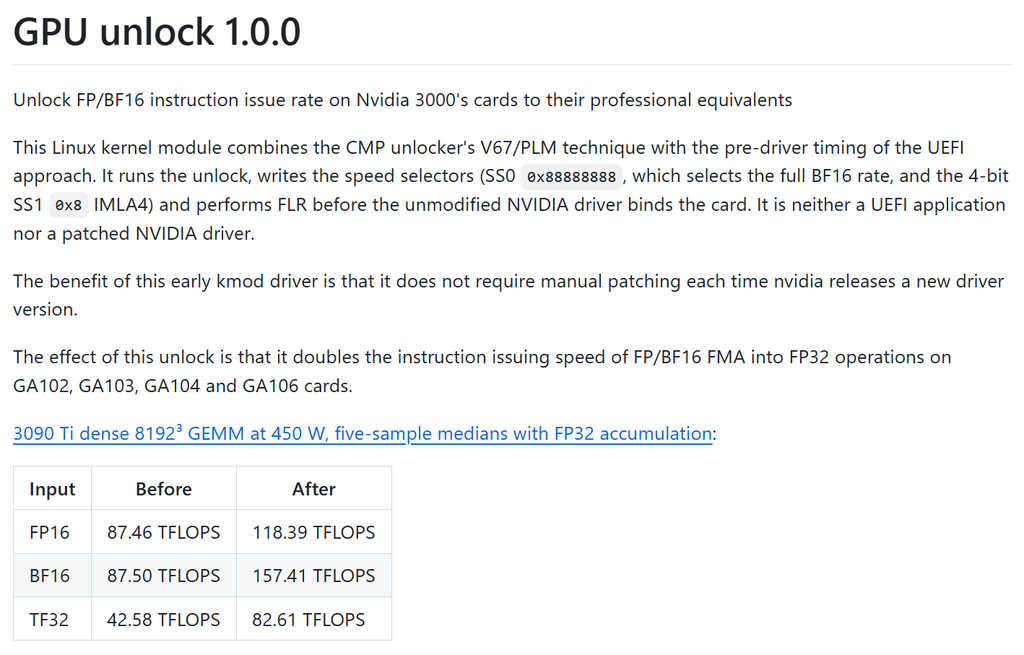
Der Grund liegt unter anderem in einer Begrenzung der Ausgaberate spezieller Tensor-Core-Befehle.
Besonders betroffen sind Berechnungen mit FP16- oder BF16-Eingabewerten und FP32-Akkumulation. Auch bestimmte TF32-Operationen können profitieren.
Solche Berechnungen kommen unter anderem beim Training und bei der Ausführung großer KI-Modelle zum Einsatz.
Der Trick steckt in den GPU-Registern
Die Modder nutzen eine Schwachstelle beziehungsweise einen bislang bekannten Angriffspfad in der GPU-Boot-Firmware, um sogenannte Speed-Selector-Register zu verändern.
Diese Register steuern, wie schnell bestimmte Rechenbefehle an die Tensor Cores ausgegeben werden können. Die Modifikation greift bereits während der Initialisierung der Grafikkarte, bevor der reguläre Nvidia-Treiber geladen wird.
Dadurch kann die Beschränkung aufgehoben werden, ohne einen modifizierten Grafiktreiber oder ein angepasstes VBIOS installieren zu müssen.
Wichtig ist allerdings: Die Mod schaltet keine zusätzlichen Tensor Cores, CUDA-Kerne oder Speicherbereiche frei. Auch die Speicherbandbreite und die VRAM-Kapazität bleiben unverändert. Stattdessen dürfen bereits vorhandene Recheneinheiten bestimmte Befehle mit einer höheren Rate verarbeiten.
GPU Unlock Benchmarks: Bis zu 100 Prozent mehr Tensor-Leistung
Die bisherigen Benchmarks zeigen, wie groß die Unterschiede bei einzelnen Berechnungen ausfallen können.
Besonders deutlich wird das bei der RTX 4090. Ihre gemessene FP16-Tensor-Befehlsrate steigt durch die Freischaltung von rund 165,6 auf 331,6 TFLOPS.
Auch auf deutlich älteren Grafikkarten sind erhebliche Verbesserungen möglich.
| Grafikkarte | Benchmark | Vorher | Nachher | Zuwachs |
| RTX 4090 | FP16-Befehlsrate | 165,6 | 331,6 | +100 % |
| RTX 4070 Ti SUPER | FP16-Befehlsrate | 95,0 | 189,9 | +100 % |
| RTX 3090 Ti | BF16-Matrixberechnung | 87,5 | 157,4 | +80 % |
| RTX 2080 Ti | FP16-Befehlsrate | 46,9 | 93,7 | +100 % |
| RTX 2080 Ti | FP16-Matrixberechnung | 48,1 | 85,2 | +77 % |
Alle Leistungswerte in TFLOPS. Die Zahlen stammen aus veröffentlichten Entwickler- und Nutzertests.
Die Verdopplung der Tensor-Befehlsrate bedeutet allerdings nicht, dass eine Grafikkarte plötzlich doppelt so schnell arbeitet.
Bei einer unabhängig getesteten RTX 4090 stieg die tatsächliche FP16-Leistung in verschiedenen cuBLAS-Matrixberechnungen beispielsweise nur um 12 bis 34 Prozent. Hier begrenzen unter anderem das Power-Limit und die Eigenschaften des jeweiligen Workloads den möglichen Zugewinn.
Trotzdem zeigen die Ergebnisse, dass Nvidia Tensor Cores bei bestimmten Berechnungen mehr Leistung liefern können, als die reguläre GeForce-Konfiguration zulässt.
Wie viel schneller werden lokale KI-Modelle durch die Mod?
Für Gamer bringt die Freischaltung nach bisherigen Erkenntnissen keine zusätzlichen FPS. Wer seine Grafikkarte dagegen für lokale KI, Machine Learning oder Bildgenerierung verwendet, könnte durchaus profitieren.
Entscheidend ist, welche Rechenoperationen die jeweilige Anwendung tatsächlich nutzt.
Lokale LLMs: Schnellere Prompt-Verarbeitung
Bei Large Language Models unterscheidet man zwischen der Verarbeitung einer Eingabe (Prefill) und der anschließenden Generierung neuer Tokens (Decode).
Die erste Phase führt viele Matrixberechnungen parallel aus und kann deshalb von einer höheren Tensor-Leistung profitieren.
Ein dokumentierter Test mit einer RTX 3090 und einem 27B-Sprachmodell zeigt beispielsweise:
- Prompt-Verarbeitung: rund 33 Prozent schneller
- Zeit bis zum ersten Token: rund 24 Prozent kürzer
- Token-Generierung: lediglich rund 1 Prozent schneller
Der Unterschied entsteht dadurch, dass bei der eigentlichen Textgenerierung häufig die Speicherbandbreite statt der verfügbaren Rechenleistung limitiert.
Bei quantisierten Sprachmodellen, beispielsweise in vielen Ollama- oder llama.cpp-Konfigurationen, können die Verbesserungen daher deutlich kleiner ausfallen.
Welche Rolle Grafikspeicher, RAM und GPU-Leistung bei lokalen Sprachmodellen spielen, erklären wir ausführlich in unserem Guide zu KI-PCs für Entwickler.
Stable Diffusion, ComfyUI und KI-Training profitieren ebenfalls
Weitere mögliche Einsatzgebiete sind KI-Bildgenerierung und das Training beziehungsweise Fine-Tuning von KI-Modellen. Das GPU-Unlock-Projekt nennt auf Basis bisheriger Nutzerberichte unter anderem folgende Leistungsverbesserungen:
| KI-Anwendung | Gemeldeter Leistungszuwachs |
| LLM-Prompt-Verarbeitung | +25 bis 55 % |
| LoRA- und BF16-Fine-Tuning | +25 bis 50 % |
| KI-Bildgenerierung mit FP16/BF16 | +30 bis 55 % |
| BF16-Videogenerierung | +15 bis 20 % |
Je nach Grafikkarte, Modell und Software kann der tatsächliche Zugewinn deutlich abweichen.
Besonders Workflows mit Stable Diffusion, SDXL und ComfyUI könnten von der zusätzlichen Rechenleistung profitieren. Allerdings bleibt ausreichend Grafikspeicher weiterhin entscheidend. Ein schnellerer Tensor-Durchsatz hilft wenig, wenn ein großes KI-Modell nicht vollständig in den VRAM passt.
Mehr dazu findest du in unserer Kaufberatung für KI Creator PCs.
Mehr FPS durch GPU Unlock? Für Gaming bringt die Mod nichts
Obwohl Nvidia auch bei DLSS auf Tensor Cores zurückgreift, lassen sich die Ergebnisse nicht einfach auf Spiele übertragen. Die Mods verändern gezielt die Leistung bestimmter Rechenoperationen, die bei herkömmlichen Gaming-Workloads keine vergleichbare Rolle spielen.
Mehr FPS, eine höhere Raytracing-Leistung oder eine bessere DLSS-Performance sind durch GPU Unlock bislang nicht nachgewiesen.
Es handelt sich also um eine Freischaltung für bestimmte KI-Berechnungen und nicht um einen allgemeinen Gaming-Performance-Mod.
Welche RTX-Grafikkarten werden unterstützt und welche Risiken gibt es?
GPU Unlock funktioniert bisher vor allem unter Linux. Die Projekte greifen sehr früh in die GPU-Initialisierung ein und müssen deshalb auf die jeweilige Hardware abgestimmt werden.
Für Windows existieren inzwischen experimentelle Umsetzungen. Diese sind allerdings noch keine universell einsetzbaren Lösungen für sämtliche GeForce-Grafikkarten.
RTX 20, 30 und 40: Unterstützung abhängig vom Modell
Bei der RTX-30-Serie gibt es bereits zahlreiche erfolgreiche Nutzerberichte, unter anderem für die RTX 3060, RTX 3070, RTX 3080 und RTX 3090.
Für die RTX-40-Serie liegen bestätigte Tests mit der RTX 4090 sowie ausgewählten weiteren Modellen vor. Dazu gehören beispielsweise die RTX 4070 Ti SUPER und RTX 4060 Ti. Auf der älteren Turing-Architektur wurde die Freischaltung erfolgreich mit einer RTX 2080 Ti demonstriert.
Die GeForce RTX-50-Serie mit Blackwell-Architektur wird derzeit nicht unterstützt. Ein funktionierender GPU Unlock für diese Generation ist bisher nicht bekannt.
Kann die Mod die Grafikkarte beschädigen?
Die Entwickler weisen ausdrücklich darauf hin, dass die Eingriffe experimentell sind. Da die Modifikation bereits vor dem regulären Treiberstart erfolgt, können Fehler im schlimmsten Fall verhindern, dass die Grafikkarte korrekt initialisiert wird oder das Betriebssystem startet.
Auch Abstürze, Datenverluste und mögliche Hardwareschäden lassen sich nicht vollständig ausschließen. Hinzu kommt, dass eine höhere Rechenleistung unter Dauerlast mehr Energie benötigen und zusätzliche Wärme erzeugen kann.
Zwar bleiben die regulären Mechanismen zur Leistungs- und Temperaturbegrenzung grundsätzlich aktiv, doch eine umfassende Langzeitvalidierung für alle unterstützten Grafikkarten liegt nicht vor. Wer die Freischaltung ausprobieren möchte, sollte deshalb die Dokumentation des jeweiligen Projekts und die konkrete Hardware-Kompatibilität sorgfältig prüfen.
Mehr KI-Leistung aus vorhandener Hardware
Die GPU-Unlock-Projekte zeigen, wie viel Rechenleistung bei bestimmten KI-Operationen auf älteren GeForce-Grafikkarten bislang ungenutzt bleibt. Besonders für lokale KI-Anwendungen, Bildgenerierung und Machine Learning könnten sich daraus zusätzliche Leistungsreserven ergeben, ohne direkt eine neue Grafikkarte kaufen zu müssen.
Würdest du die Tensor-Leistung deiner Grafikkarte per Mod freischalten oder wäre dir das Risiko zu groß? Schreib uns deine Meinung gerne in die Kommentare!
- Lesedauer 7 min

Marcel Bruns
Autor
Marcel stammt aus Bonn und ist im Berliner Umland aufgewachsen. Schon in der Schulzeit entwickelte er eine Leidenschaft für Technik und Gaming – seinen ersten PC zerlegte er direkt nach dem Auspacken, einfach um zu verstehen, wie er funktioniert. Bis heute baut er regelmäßig Gaming-PCs für sich und Freunde zusammen. Wenn er gerade nicht an seinem PC herumschraubt, taucht er gerne in die Welt der Anime ein und träumt davon, einmal Japan zu bereisen. In seiner Freizeit trifft man ihn entweder beim Zocken des neuesten AAA-Titels oder dabei, seine Teammates in League of Legends (mehr oder weniger absichtlich) zu inten.
Mehr erfahren >>